Jev im Vergleich zu textgenerierenden Modellen
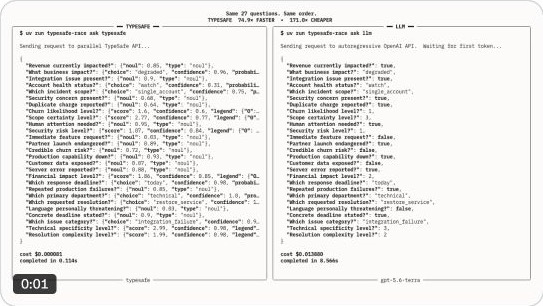
Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Eine große Frage erreicht 62,6 % Genauigkeit, fünf kleine erreichen 95,0 % mit demselben Modell. Jev generiert keinen Text, sondern wählt aus vorgegebenen Antworten aus; bei granularer Fragestellung schlägt es Haiku 4.5.
ONE BIG QUESTION: 62.6% ACCURATE. FIVE SMALL ONES: 95.0%. SAME MODEL. the whole lesson of this article is in that jump. jev doesn't write. it only picks from answers you allow. ask it one vague question per email and it guesses. split it into 5 small ones and it beats haiku 4.5
Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Der Launch Thread erklärt Code plus AI Workflow Evaluationen, den angekündigten Eingabepreis und kostenlose Ausgabetokens.


Dieses Modell ist für Entscheidungsfindung statt Textgenerierung konzipiert und gibt Wahrscheinlichkeiten für jede Option parallel aus, anstatt Antworten Token für Token zu liefern. Der Autor zeigt ein vereinfachtes Beispiel für normale LLMs im Vergleich zu diesem Jev-Modell.
