Jev im Vergleich zu textgenerierenden Modellen
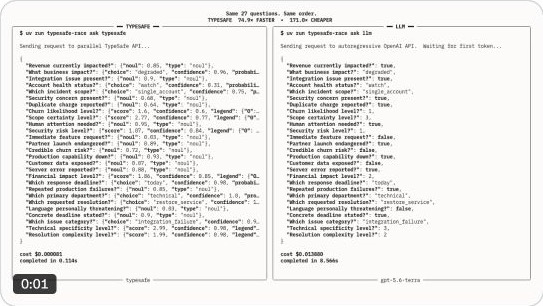
Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Der Beitrag sagt, dass die JEV-Signallandschaft zeigt, wie sechs Eingabequellen in einem einzigen Agenten verarbeitet werden können, statt für jede Eingabe separate Parser, Prompts und Codepfade zu benötigen.
WHOEVER LEAKED THIS JEV LANDSCAPE OF SIGNALS DESERVES THE CTO SEAT I thought handling six input feeds in one agent meant six parsers, six prompts, and six code paths that disagree in production. Apparently not. This landscape's setup is much more interesting: → SOURCES: 6
Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Der Launch Thread erklärt Code plus AI Workflow Evaluationen, den angekündigten Eingabepreis und kostenlose Ausgabetokens.


Dieses Modell ist für Entscheidungsfindung statt Textgenerierung konzipiert und gibt Wahrscheinlichkeiten für jede Option parallel aus, anstatt Antworten Token für Token zu liefern. Der Autor zeigt ein vereinfachtes Beispiel für normale LLMs im Vergleich zu diesem Jev-Modell.
